
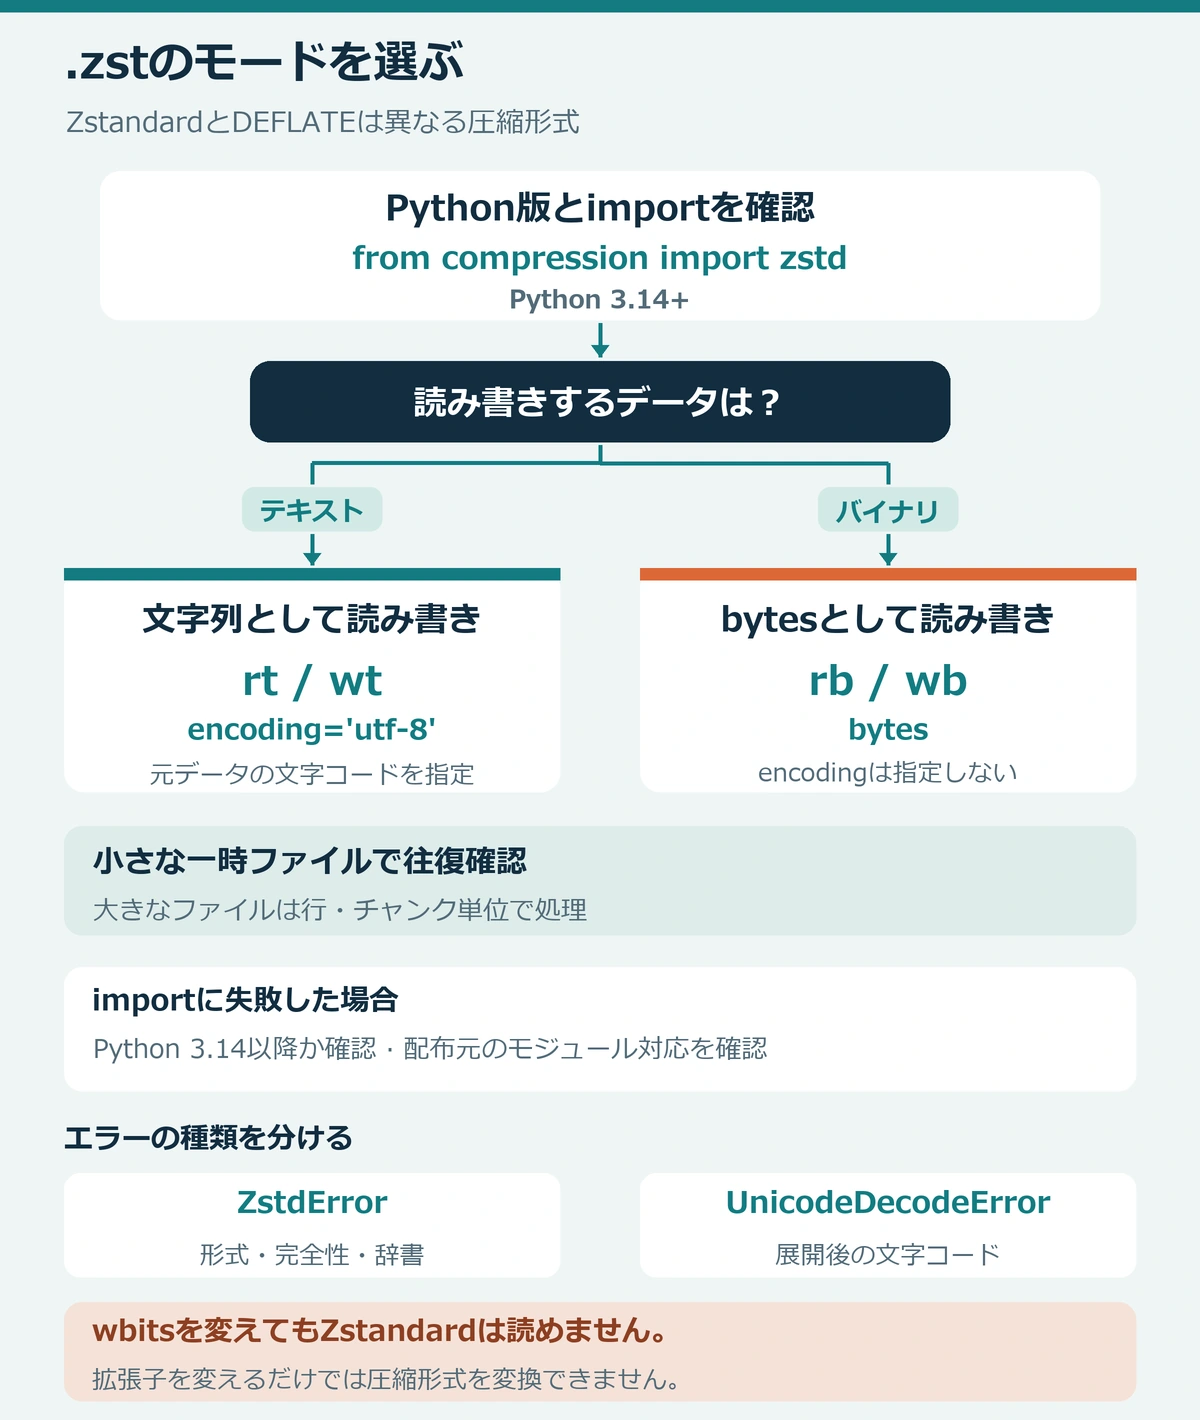
Python 3.14以降では、標準ライブラリのcompression.zstdでZstandard形式の.zstファイルを読み書きできます。標準APIのimportはfrom compression import zstdです。UTF-8などのテキストはrt・wtとencoding、バイナリはrb・wbを使います。zlibはDEFLATE系の別形式であり、wbitsを変えてもZstandardの読込みAPIにはなりません。
compression.zstdはPython 3.14で追加済みです。公式資料には、bytes向けcompress()・decompress()と、ファイル向けopen()・ZstdFileがあります。
以下は2026年10月4日時点のPython 3.14固定版の公式資料に基づきます。
最初にPythonとモジュールを確認する
import sys

print(sys.version)
print(sys.executable)

from compression import zstd

print(zstd.__name__)
Python 3.13以下では標準のcompression.zstdは使えません。また、3.14でもこれはoptional moduleです。利用中のCPython配布に含まれない場合は、Pythonを提供したディストリビューターの資料を確認してください。PEP 784では、libzstdがない環境ではモジュールを利用できないと説明されています。
import zstandardやimport zstdは外部パッケージの名前で、標準APIとは別です。PEP 784では、名前衝突を避けるためcompression.zstdが採用されています。
UTF-8テキストを書き込み、読み戻す最小例
既存ファイルを誤って上書きしないよう、一時ディレクトリで往復を確認する例です。
from compression import zstd
from pathlib import Path
from tempfile import TemporaryDirectory


text = 'Hello, Zstandard!\n'

with TemporaryDirectory() as directory:
    path = Path(directory) / 'sample.txt.zst'

    with zstd.open(path, 'wt', encoding='utf-8') as output:
        output.write(text)

    with zstd.open(path, 'rt', encoding='utf-8') as source:
        restored = source.read()

    assert restored == text
print(restored, end='')wt・wbに出力先のパスを指定すると既存ファイルを上書きするため、出力先を確認してください。encoding、errors、newlineはテキストモード用です。
既存の.zstを読む
テキストを行単位で読む
from compression import zstd


with zstd.open('input.txt.zst', 'rt', encoding='utf-8') as source:
    for line in source:
print(line, end='')実データがUTF-8とは限りません。展開には成功してもUnicodeDecodeErrorになる場合は、圧縮破損だけでなく、元テキストの文字コード指定を確認します。JSONやCSVとしての解析エラーは、Zstandard展開後の別の層です。
バイナリをチャンクで読む
from compression import zstd


with zstd.open('input.bin.zst', 'rb') as source:
    while chunk := source.read(1024 * 1024):
print(len(chunk))画像、モデル、独自形式などはrbでbytesとして扱い、バイナリモードではencodingを指定しません。大きなファイルを常にread()で一括取得するのではなく、利用側の処理に合わせてチャンクや行単位で読みます。
少量のbytesならcompress・decompressを使う
from compression import zstd


original = b'Hello, Zstandard!\n'
packed = zstd.compress(original)
restored = zstd.decompress(packed)

assert restored == originalこのAPIはbytes-likeな入力をまとめて処理し、bytesを返します。ファイルを逐次扱う用途ではzstd.open()を選びます。
読めないときの切り分け
| 症状 | 確認すること |
|---|---|
ModuleNotFoundError・ImportError | 実行中のPythonが3.14以降か、同じ実行ファイルにoptional moduleが含まれるか |
ZstdError | 実データがZstandardか、ダウンロードが完全か、必要なZstandard辞書があるか |
UnicodeDecodeError | 展開後データが本当にテキストか、指定した文字コードが正しいか |
zlib.errorやheader関連エラー | Zstandardデータをzlibへ渡していないか、元の圧縮形式が何か |
zlib公式資料のwbitsは、zlib、gzip、raw DEFLATEのheaderやwindowを選ぶ引数です。Zstandardは別形式なので、wbitsの変更や拡張子の付け替えでは変換できません。また、header関連エラーだけで「必ずZstandardファイル」「必ず破損」と断定することもできません。
圧縮辞書を使って作られたデータは、対応するZstandard辞書をzstd_dictへ渡す必要があります。提供元の仕様を確認してください。
.zstと.tar.zstは同じ扱いではない
sample.txt.zstは単一データをZstandard圧縮したものとして扱えますが、archive.tar.zstはZstandardを展開した後にtarアーカイブが残ります。Python 3.14のtarfileにはZstandard対応モードもありますが、単一テキストの読込みとは処理目的が異なります。
よくある質問
Python 3.14ならpipは必ず不要ですか?
標準APIなので通常は外部パッケージを前提としませんが、optional moduleが含まれないCPython配布もあります。その場合にpip install compressionを標準APIの導入手順として案内することはできません。配布元の対応を確認します。
.gzもcompression.zstdで読めますか?
読めません。.gzはgzip形式、.zstはZstandard形式です。拡張子だけでなく、生成元が示す実際の形式に合うモジュールを使います。
まとめ
Python 3.14で.zstを扱うときは、from compression import zstdを使い、テキストとバイナリのモードを分けます。エラー時はimport環境、圧縮形式、辞書、文字コードを別々に確認し、zlibの設定変更でZstandardを読もうとしないでください。


コメント