
大きな入力列をExecutor.map()へ渡すとき、調整したいのが「同時に動く数」なのか、「結果を受け取る前に先行投入する数」なのかを分けて考える必要があります。Python 3.14で追加されたbuffersizeは後者を制御する引数です。max_workersの別名でも、使用メモリの上限値でもありません。
結論:
max_workersはワーカー数の上限、buffersizeはまだ結果としてyieldされていない投入済みタスク数の上限、chunksizeは主にProcessPoolExecutorで入力をまとめる単位です。
buffersizeで変わるのは入力の先行消費
Python 3.14のconcurrent.futures公式ドキュメントでは、既定のbuffersize=Noneでは入力イテラブルを遅延ではなく直ちに収集すると説明されています。正の値を指定すると、結果がまだyieldされていない投入済みタスク数を制限し、バッファが満杯の間は入力イテラブルの反復を止めます。利用側が返された結果イテレータの反復を進めると、空きに応じて次の入力が取り出されます。
したがって、長いジェネレーターを渡す場面では、buffersizeによって「結果を読み進める速さに合わせて入力を消費する」流れを作れます。ただし、値はバイト数ではありません。入力オブジェクト、結果、タスク管理情報、処理関数が保持するデータなどで使用メモリは変わるため、厳密なRAM上限にはなりません。
max_workers・buffersize・chunksizeの違い
| 引数 | 決めるもの | 注意点 |
|---|---|---|
max_workers | 同時実行に使うワーカー数の上限 | Executor作成時に指定する。投入待ちの総数とは別 |
buffersize | 結果がまだyieldされていない投入済みタスク数の上限 | Python 3.14でExecutor.map()に追加。RAM容量の指定ではない |
chunksize | 入力をプロセスへ渡すおおよその分割単位 | ProcessPoolExecutorで使われ、ThreadPoolExecutorとInterpreterPoolExecutorには効果がない |
ProcessPoolExecutorでは、複数の入力要素が一つのチャンクとして投入されます。そのため、buffersizeを入力要素数そのものと読み替えず、chunksizeとの組み合わせで考えます。
Eventで入力消費を観察する
次は、入力7個、max_workers=2で比較する検証用コードです。各タスクをEventで待機させるため、sleep時間や実行速度の偶然に頼らず、map()を呼んだ直後にジェネレーターが何個消費されたかを確認できます。掲載コードはWindows上のCPython 3.14.8で実行し、直後の入力消費と結果順を確認しています。処理速度やRAM使用量は計測していません。
from concurrent.futures import ThreadPoolExecutor
from threading import Event


def observe(buffersize):
    gate = Event()
    consumed = []

    def source():
        for value in range(7):
            consumed.append(value)
            yield value

    def work(value):
        gate.wait()
        return value * 10

    with ThreadPoolExecutor(max_workers=2) as executor:
        options = {} if buffersize is None else {"buffersize": buffersize}
        results = executor.map(work, source(), **options)

        print(f"buffersize={buffersize}, map直後={consumed}")
        gate.set()

        yielded = []
        for result in results:
            yielded.append(result)
            print(f"yield={result}, 入力消費={consumed.copy()}")

        print("結果:", yielded)


observe(None)
observe(3)未指定のケースでは、map()から戻った時点で7個すべてが入力から取り出されます。buffersize=3では、タスクがEvent待ちで結果を返せないため、直後の消費は先頭3個で止まります。ゲートを開いて結果の反復を進めると、残りの入力も順次取り出されます。返される結果は通常のmap()と同じ入力順です。
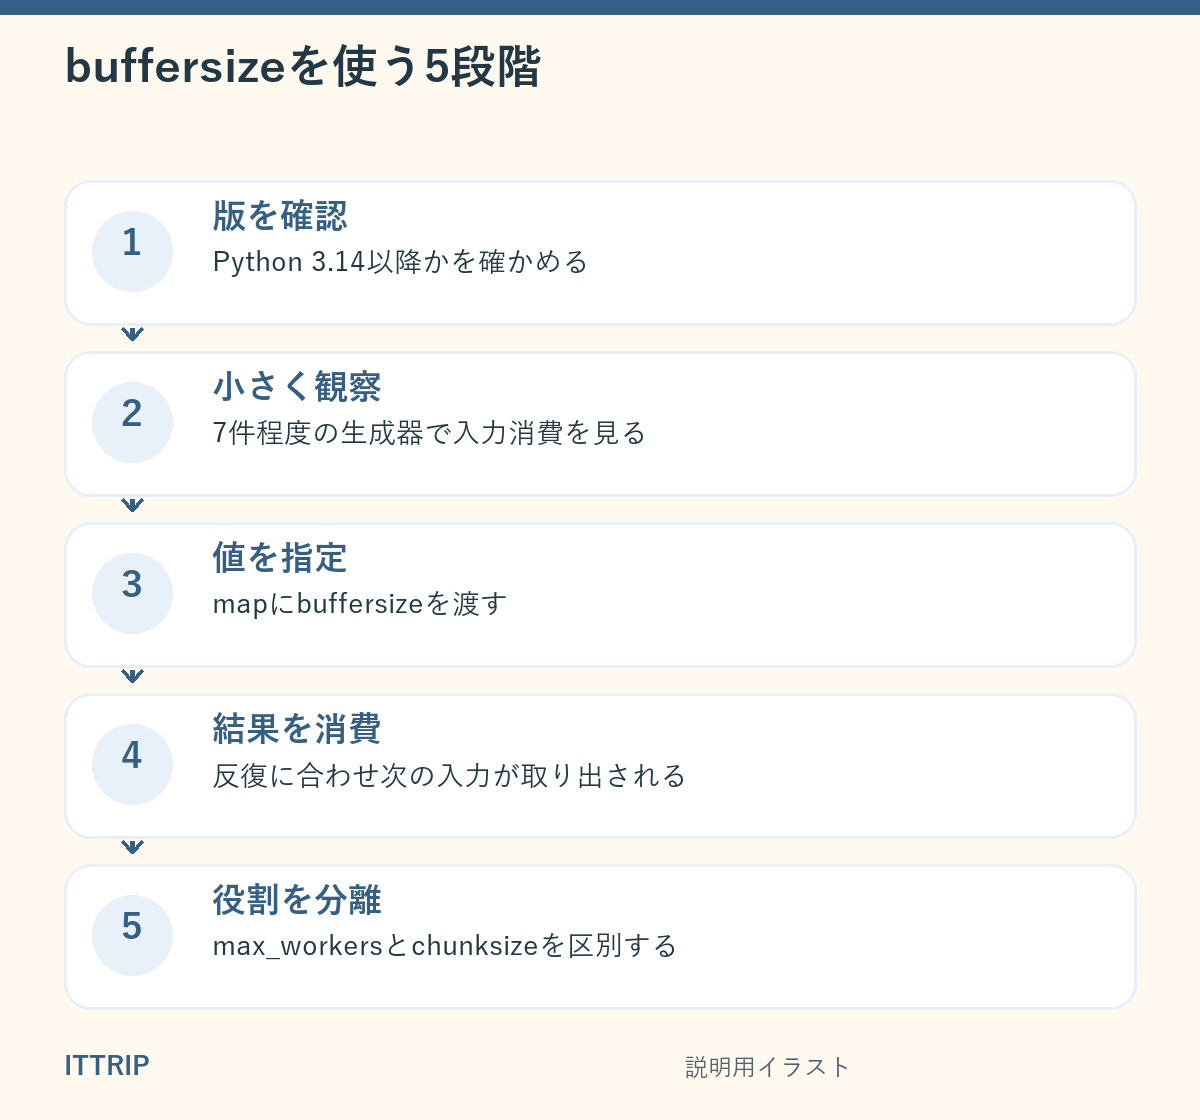
値を決めるときの見方
- まずPythonの版を確認する:
buffersizeはPython 3.14で追加されたため、それ以前の実行環境では使えません。 - max_workersを先に分ける:スレッドやプロセスをいくつ使うかは、処理内容と実行環境に合わせて決めます。
- buffersizeは先行投入量として試す:入力生成やタスク保持の負担を観察しながら、結果消費との釣り合いを調整します。
- ProcessPoolだけchunksizeも見る:プロセス間で渡すまとまりを変える引数であり、スレッド版の調整には使いません。
- 速度とメモリは実測する:
buffersizeを小さくすれば必ず高速化する、または一定量だけメモリが減るとは限りません。
buffersizeが保証するのは、公開APIとしての先行投入制御です。内部キューの瞬間的な状態やメモリ使用量を固定する機能ではありません。大量入力では、小さな再現例で入力消費を確認してから、実データで処理時間とメモリを別々に測るのが安全です。
まとめ
Python 3.14のExecutor.map(buffersize=...)は、大きな入力を一度に先行投入せず、結果の消費に合わせて入力反復を進めたいときに使います。max_workersは実行ワーカー数、buffersizeは未yieldの投入済みタスク数、chunksizeはProcessPoolの分割単位です。この3つを同じ「並列数」と考えず、役割ごとに設定してください。
Python 3.14への移行後にヘルプやログの色も調整したい場合は、argparseの色コードを無効にする方法も参考にできます。

コメント